Decision-1 ofrece salidas estructuradas para decisiones. Una puntuación no explica el razonamiento, no confirma los hechos y necesita evaluación con casos propios.
Qué es Microsoft-Decision-1
Microsoft-Decision-1 es un modelo orientado a decisiones estructuradas. La documentación de Azure Foundry, actualizada el 9 de octubre de 2026, describe salidas de probabilidad, elección entre opciones o puntuación sobre entradas de texto y JSON.
La diferencia para entenderlo es sencilla: en lugar de escribir una respuesta extensa, devuelve una salida que otro programa puede utilizar. No genera una explicación redactada de su decisión. Su despliegue requiere una suscripción y configuración de Azure, con permisos y método de pago.
Microsoft también documenta sensibilidad a la formulación y al orden de opciones, posibles sesgos y conocimiento desactualizado. No hemos verificado precios regionales, disponibilidad por región ni realizado mediciones de rendimiento.
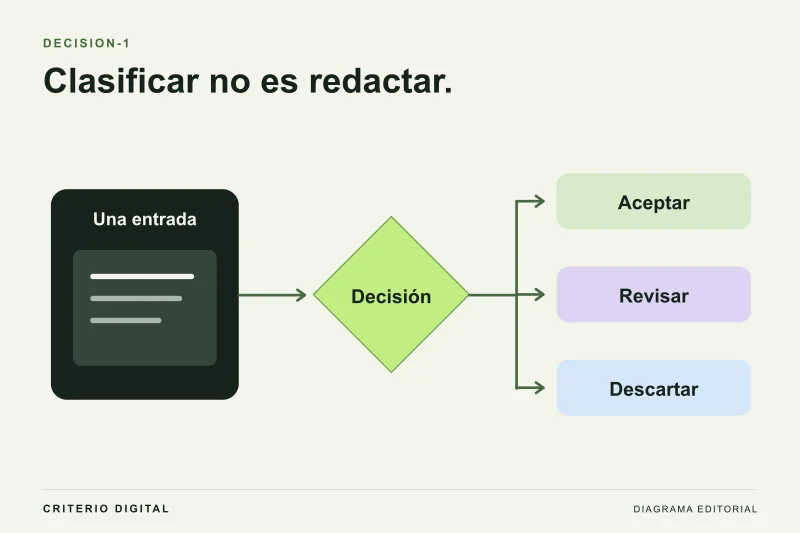
Clasificar un problema no equivale a resolverlo
Imagina una bandeja con consultas de clientes. Separarlas en «facturación», «acceso» y «problema técnico» puede ayudar a enviarlas a la persona adecuada. Pero la etiqueta «facturación» no demuestra que un cobro sea incorrecto ni autoriza una devolución.
Esa separación evita una confusión frecuente: automatizar el primer paso de un proceso no convierte el resto en automático. Un sistema puede clasificar bien y, aun así, ejecutar mal una acción posterior porque faltan contexto, permiso o comprobaciones.
El selector utiliza tres casos inventados y reglas fijas para explicar la diferencia. No consulta Decision-1, no reproduce sus probabilidades y no debe usarse como comparación de modelos.
Una tabla para decidir qué comprobar
| Uso propuesto | Qué puedes verificar | Qué requiere otra comprobación |
|---|---|---|
| Ordenar solicitudes | Coincidencia con categorías definidas de antemano. | Que la solución posterior sea correcta. |
| Detectar información incompleta | Casos que se derivan para pedir más datos. | Que una puntuación alta signifique certeza. |
| Priorizar revisión | Errores y retrasos por cada tipo de solicitud. | Que nadie quede injustamente excluido. |
| Decidir sobre personas | Trazabilidad y posibilidad de revisión. | No delegar una decisión importante en una cifra sin supervisión. |
La última fila merece especial atención. Una puntuación puede parecer objetiva por tener decimales, pero el formato numérico no elimina los errores del sistema. La consecuencia del fallo importa más que la apariencia de precisión.
Cómo preparar una evaluación útil antes de automatizar
Construye primero una pequeña colección de ejemplos ficticios o debidamente autorizados. Incluye mensajes claros, ambiguos, con errores de escritura y con dos problemas a la vez. Define las etiquetas esperadas sin mirar la salida del modelo.
- Escribe qué significa cada categoría y cuándo falta información.
- Reserva casos que no utilices para ajustar las instrucciones.
- Comprueba errores por categoría, no solo un porcentaje global.
- Reformula algunos mensajes y cambia el orden de opciones para observar estabilidad.
- Define qué situaciones siempre pasan a revisión humana.
Una opción como «no hay información suficiente» puede ser más útil que forzar una decisión. Si la siguiente acción implica dinero, acceso a una cuenta o consecuencias para una persona, el procedimiento necesita una revisión proporcionada a ese riesgo.
Los límites de aceptación dependen del proceso: confundir dos carpetas internas y rechazar una reclamación no tienen la misma consecuencia. No proponemos un umbral universal ni una nota a partir de la cual cualquier automatización sea segura.
Qué no cuenta una comparación de velocidad
Un resultado rápido solo es útil si responde a la tarea correcta. Antes de comparar modelos, mantén iguales las entradas, las categorías, las comprobaciones y el criterio de error. Mide también las respuestas que una persona debe corregir.
Si un fabricante publica un benchmark, identifica quién lo hizo y qué conjunto de tareas evaluó. No lo conviertas en «es mejor para todo» ni extrapoles su coste a una cuenta con otra carga de trabajo. Aquí no repetimos cifras de rendimiento como si fueran pruebas independientes.
Para empezar por una tarea cotidiana, nuestra guía sobre comprobación de resúmenes de IA muestra por qué una respuesta necesita contrastarse con el documento original.
Opinión editorial: la utilidad de un modelo que elige está en diseñar bien las opciones y reconocer cuándo no debe decidir. Añadir una salida numérica no resuelve por sí solo ninguna de esas dos tareas.
Preguntas frecuentes sobre Decision-1
¿Decision-1 es otro chatbot?
Está orientado a salidas estructuradas de decisión, no a conversar mediante explicaciones extensas. El acceso documentado es a través de Azure Foundry.
¿Una probabilidad alta demuestra que tiene razón?
No. Debe evaluarse en el contexto concreto, incluyendo errores, casos ambiguos y cambios de formulación.
¿Hemos probado el modelo en Criterio Digital?
No. El ejercicio de esta página es una demostración local de clasificación con reglas visibles, sin conexión al modelo.
Qué hemos comprobado en esta pieza
El alcance de esta noticia es documental: las fuentes enlazadas respaldan los anuncios y sus condiciones. No acredita una prueba de acceso desde tu país, dispositivo o plan. Si necesitas decidir una contratación, comprueba la función exacta en tu cuenta antes de pagar.
Fuentes y comprobación
Fuentes consultadas el 13 de octubre de 2026. Las funciones y condiciones pueden cambiar. Los ejemplos inventados se identifican como tales.
15 de octubre de 2026: reorganización de los pasos, eliminación de repeticiones y aclaración del alcance de la evidencia. La fecha de consulta de fuentes figura por separado.
¿Has encontrado un error? Comunica una corrección.